

Die technologische Evolution von reinen Informationsabrufsystemen hin zu autonom agierenden Entitäten markiert einen fundamentalen Wendepunkt in der Softwarearchitektur und der betriebswirtschaftlichen Prozessautomatisierung. Das Konzept einer „Karpathy Agenten-Architektur“ beschreibt die praktische Umsetzung dieser Vision. Inspiriert durch die theoretischen Entwürfe und Experimente von Andrej Karpathy, dem Mitbegründer von OpenAI, ehemaligen Leiter der KI-Abteilung bei Tesla und aktuell bei Anthropic, vollzieht sich hierbei der Übergang von statischen Chatbots zu dynamischen, selbstgesteuerten Agenten-Netzwerken. In diesem Bericht analysieren wir die architektonischen Säulen dieser Entwicklung, vergleichen führende Open-Source-Frameworks und demonstrieren die weitreichenden Implikationen für moderne Marketing-Technologiesysteme (MarTech-Systeme).
Das Paradigma von Software 3.0 und das LLM als Betriebssystem
Die theoretische Grundlage für autonome Agenten-Systeme basiert auf Karpathys Definition von „Software 3.0“. Während sich Software 1.0 auf klassischen, von Menschen geschriebenen Programmcode stützt und Software 2.0 die Ära der neuronalen Netze einläutete, bei denen Programmergebnisse durch Daten und Gewichte gelernt werden, deklariert Software 3.0 Large Language Models (LLMs) als universelle, sprachbasierte Routing- und Denk-Engines. Der Code weicht hierbei der Instruktion in natürlicher Sprache, wodurch die traditionelle Programmierlogik durch iterative Konversation und kontextuelle Logik ersetzt wird.
In diesem Kontext ist die Analogie des LLMs als neues Betriebssystem (LLM OS) – oder agentisches Betriebssystem – von zentraler Bedeutung. Ein modernes LLM fungiert nicht länger nur als Textgenerator, sondern übernimmt die Rolle eines Kernels, der Ressourcen verwaltet, Werkzeuge orchestriert und Speicherhierarchien steuert. Die Analogie lässt sich bis in die Pionierzeit der Informatik zurückverfolgen, da die aktuelle KI-Landschaft stark an die Time-Sharing-Ära der 1960er-Jahre erinnert, in der extrem teure, zentralisierte Rechenressourcen über Remote-Terminals geteilt genutzt wurden.
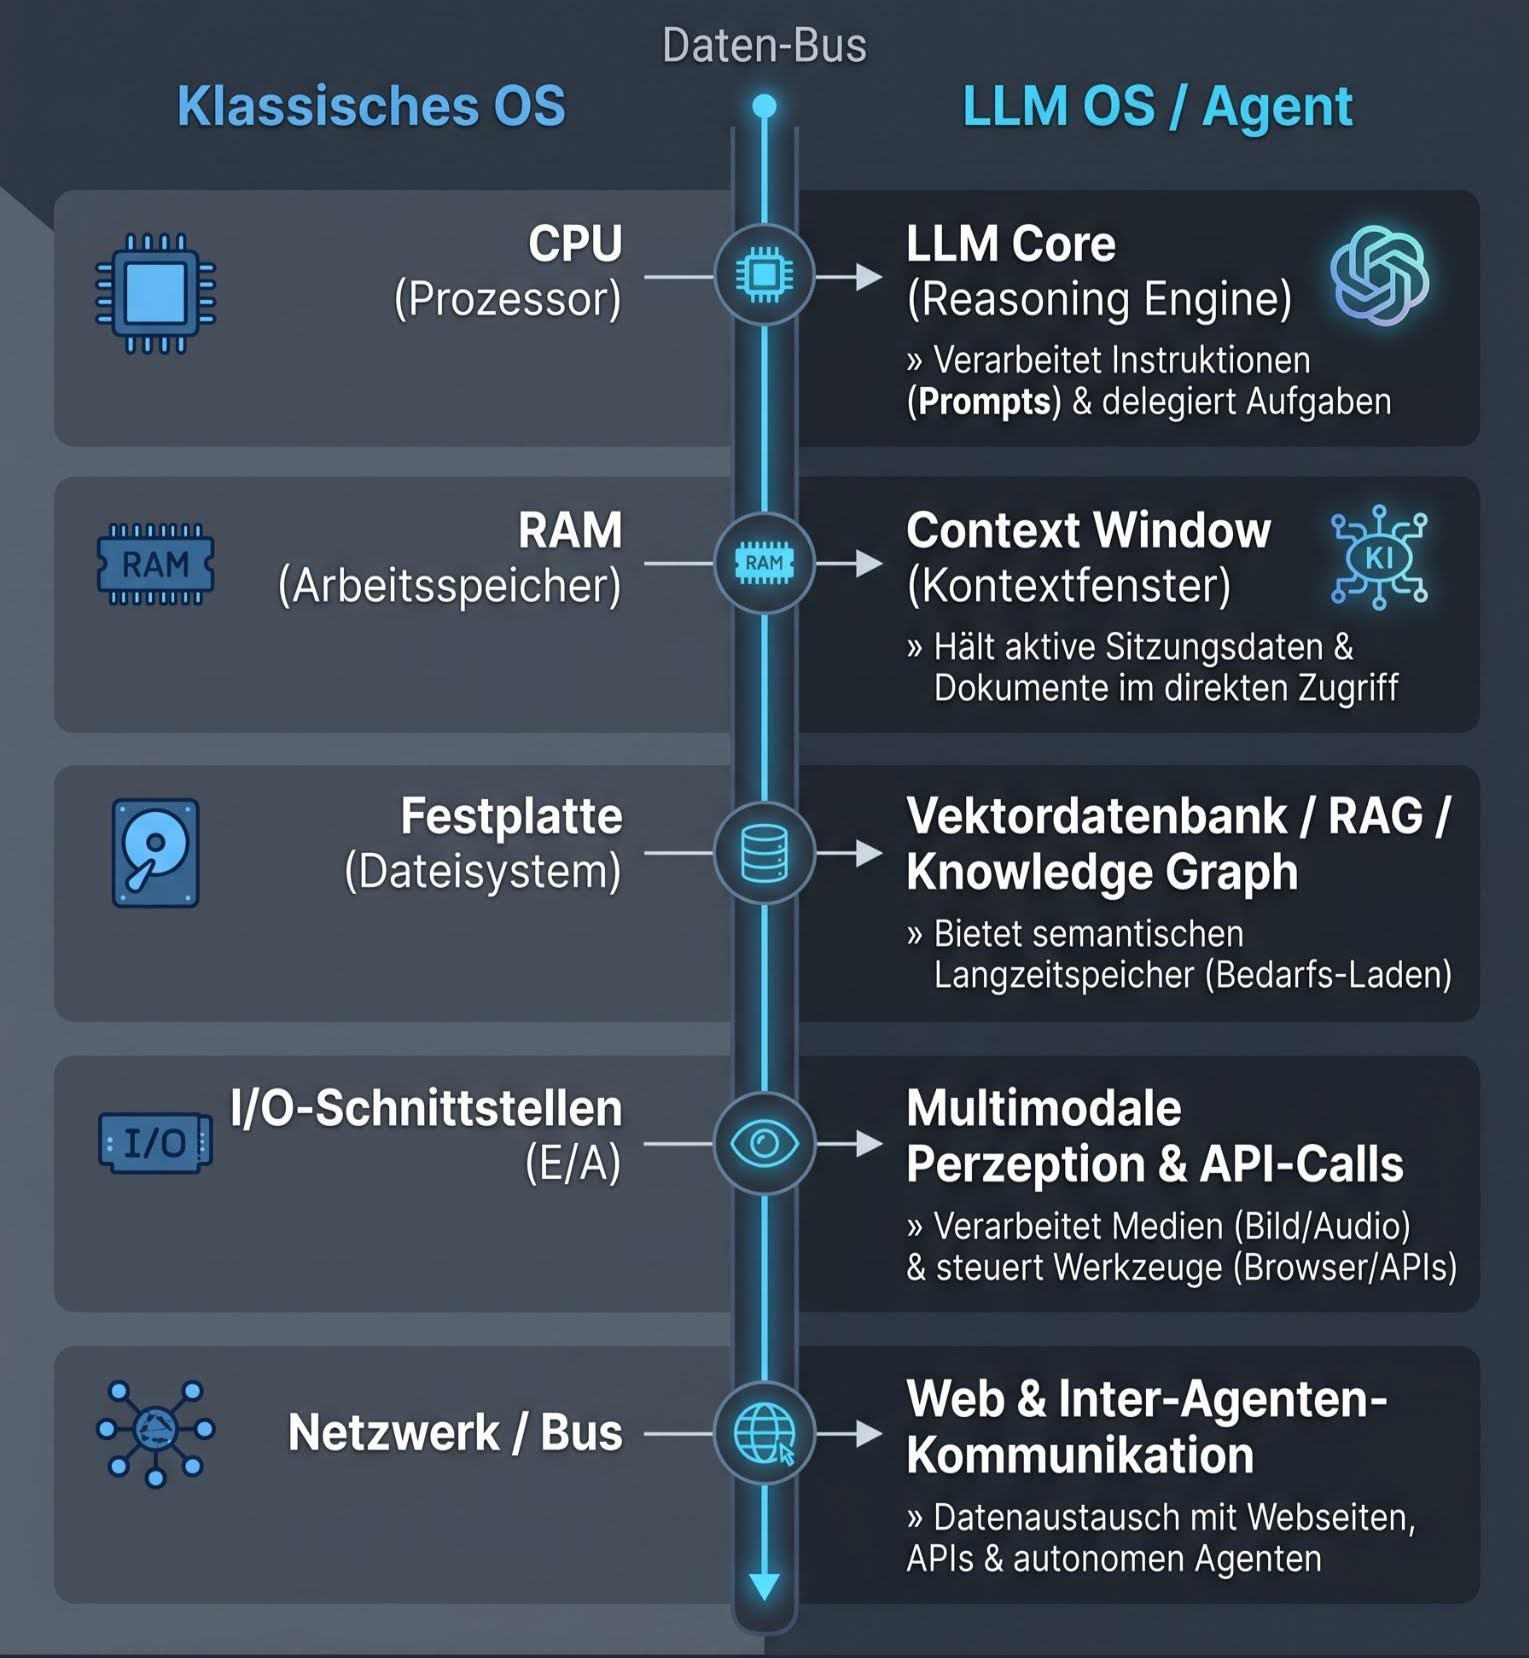
Dieses Betriebssystem-Modell verschiebt die Herausforderungen der Anwendungsmodernisierung grundlegend. Die entscheidende Frage für Entwickler und IT-Architekten lautet nicht mehr, wie eine KI in eine bestehende Anwendung integriert werden kann, sondern wie bestehende Anwendungen so umgestaltet werden können, dass sie nativ auf diesem neuen LLM-Betriebssystem lauffähig sind.
Die Generierung von Applikationen innerhalb dieses Betriebssystems erfolgt dynamisch und bedarfsgerecht. Das System verfügt über keine vorinstallierten Standardanwendungen, sondern erzeugt, testet und isoliert Programme in Echtzeit basierend auf natürlichsprachlichen Beschreibungen. Hierbei skaliert die Betriebssystem-Schnittstelle ihre kognitive Kapazität dynamisch anhand der verfügbaren Hardwareressourcen, was durch ein mehrstufiges Intelligenzmodell abgebildet wird.
| Intelligenzstufe | Erforderliche Modellklasse | Funktionsumfang und Routing-Ebene |
|---|---|---|
| Stufe 0 | Keine Modelle (Regex-Ebene) | Ausschließlich deterministisches Keyword-Matching und statische App-Vorlagen. |
| Stufe 1 | Tiny LLM (0,5B bis 1B Parameter) | Lokales, extrem schnelles Modell zur Prompt-Klassifizierung und Vorlagen-Routing. |
| Stufe 2 | Local LLM (7B bis 14B Parameter) | Autonome, lokale App-Generierung ohne Cloud-Abhängigkeit über Ressourcenmonitore. |
| Stufe 3 | Cloud-Schnittstellen (z.B. GPT-5, Claude) | Vollständige Modell-Eskalation für hochkomplexe, unstrukturierte Entwicklungsaufgaben. |
Um die Ausführungssicherheit zu garantieren, durchlaufen generierte Programme einen mehrstufigen Filter. Ein deterministischer Sicherheits-Scan blockiert riskante Operationen wie dynamische Code-Auswertungen oder unbefugte Frame-Zugriffe, bevor Anwender die angeforderten Berechtigungen explizit freigeben. Die Ausführung selbst erfolgt in isolierten Sandbox-Umgebungen wie WebAssembly (WASM) oder Docker-Containern unter Verwendung kryptografisch signierter Autorisierungstoken.
Technische Standardisierung autonomer Systeme: CLAUDE.md versus AGENTS.md
Um die typischen Fehlermuster von autonomen Systemen systematisch zu minimieren, etablierten sich strukturierte Verhaltensrichtlinien in Form von Markdown-Konfigurationsdateien. Die von der Entwicklergemeinschaft adaptierte CLAUDE.md-Spezifikation basiert auf Karpathys empirischen Beobachtungen über die häufigsten Fehlerquellen codierender KI-Systeme. Diese Richtlinien fokussieren sich auf vier fundamentale Verhaltenskodizes zur Steigerung der Präzision bei der softwarebasierten Systeminteraktion:
- Erst denken, dann handeln (Think before coding): Der Agent muss vor der Code-Modifikation explizit Annahmen formulieren, architektonische Abwägungen treffen und bei Unklarheiten Rückfragen stellen, was unkontrollierte Fehlannahmen verhindert.
- Einfachheit priorisieren (Simplicity first): Da Modelle oft zu komplexen, monolithischen und fragilen Konstruktionen neigen, verpflichtet diese Regel das System zur minimalen, funktionalen Implementierung.
- Präzise Eingriffe (Surgical changes): Modifikationen dürfen ausschließlich an den angeforderten Stellen erfolgen, wodurch unaufgeforderte Refaktorisierungen oder kosmetische Code-Formatierungen unterbunden werden.
- Zielorientierte Ausführung (Goal-driven execution): Das gewünschte Endergebnis wird exakt definiert; der Agent wählt den optimalen Pfad autonom und verifiziert das Ergebnis anhand automatisierter Tests.
Während CLAUDE.md primär die Interaktion zwischen einem menschlichen Entwickler und einem assistierenden Programmierwerkzeug optimiert, adressiert der von der Linux Foundation verwaltete offene Standard AGENTS.md die Herausforderungen vollkommen autonomer Systeme, die ohne direkte menschliche Aufsicht agieren.
| Kernregeln für AGENTS.md | Technische Umsetzung und deklarative Syntax | Sicherheitsrelevanz und Fehlervermeidung |
|---|---|---|
| Berechtigungsgrenzen | Explizite Deklaration erlaubter und verbotener Pfade im Systemprompt. | Verhindert den unbefugten Zugriff auf Umgebungsvariablen und Produktionsdatenbanken. |
| Auditierbarkeit | Lückenlose Protokollierung aller Tool-Aufrufe und Systemänderungen. | Ermöglicht die vollständige Rekonstruktion und das Rollback von Systemzuständen. |
| Lautes Versagen | Sofortiger Abbruch bei unvorhergesehenen Systemgrenzen statt Improvisation. | Verhindert unkontrollierte Halluzinationen und Folgefehler im operativen Betrieb. |
| Physische Speicherdatei | Kontinuierliches Schreiben und Auslesen einer MEMORY.md-Struktur. | Schützt vor Kontextverlust bei Inferenz-Resets und sorgt für kumulatives Lernen. |
Dieser Standard wird mittlerweile nativ von führenden KI-Entwicklungsplattformen wie OpenAI Codex, Cursor und GitHub Copilot interpretiert, wobei Entwicklern empfohlen wird, eine zentrale Master-Datei zu pflegen und diese per Symlink mit werkzeugspezifischen Konfigurationen zu verknüpfen.
Das Wissensschicht-Problem und die Speicherarchitektur
Ein zentrales Nadelöhr im Design autonomer Agenten-Systeme ist das von Karpathy beschriebene Problem der Wissensschicht. Herkömmliche Retrieval-Augmented Generation (RAG) durchsucht unstrukturierte Rohdaten bei jeder Benutzeranfrage isoliert von neuem. Dadurch führt der Agent bei jeder Interaktion dieselbe kognitive Erfassungsarbeit redundant aus, ohne dass erarbeitete Zusammenhänge dauerhaft kumuliert werden.
Zur Überwindung dieser Ineffizienz dient das Konzept des LLM-Wiki-Compilers. Hierbei werden unstrukturierte Datenquellen, PDFs und Notizen vorab in ein engmaschiges Netz aus strukturierten Markdown-Seiten überführt. Der Agent navigiert anschließend durch diese vorkompilierte, semantische Enzyklopädie, anstatt unstrukturierte Textfragmente zu durchsuchen.
Diese Architektur birgt jedoch Herausforderungen bezüglich der Aktualität und Provenienz der Daten. Sobald synthetisierte Wiki-Seiten aufeinander aufbauen, besteht die Gefahr, dass veraltete Informationen ungeprüft fortgeschrieben werden und der Agent an Wahrheitsgehalt einbüßt. Moderne Agentensysteme implementieren daher Frische-Indikatoren und hybride Suchalgorithmen, um die Zuverlässigkeit der Wissensbasis kontinuierlich zu verifizieren.
Strategische Marketing Use Cases der Karpathy Agents Agency
Für Marketing-Organisationen und moderne Tech-Teams eröffnet die Verschmelzung von Agenten-Frameworks mit Kommunikationsprotokollen wie dem Model Context Protocol (MCP) vollkommen neue Wertschöpfungsketten. Das MCP fungiert hierbei als universeller Übersetzer, der relationale Datenquellen, CRM-Systeme und Werbeplattformen ohne komplexe, proprietäre API-Schnittstellen für KI-Agenten erschließt.
| Marketing Use Case | Integrierte MarTech-Systeme | Agentischer Lösungsansatz & MCP-Schnittstelle | Betriebswirtschaftlicher ROI & Impact |
|---|---|---|---|
| Kanalübergreifende Kampagnenanalyse | Google Ads, Facebook Ads, TikTok, HubSpot, CRM | Konnektierung von MCP-Servern zur automatischen Abfrage und Normalisierung der Metriken. | Reduktion des wöchentlichen Analyseaufwands von 4 Stunden auf 4 Minuten. |
| Proaktive GEO / SEO-Content-Gap-Analyse | Search Console, Google Analytics, WordPress, Semrush | Kontinuierliche Überwachung von Keywords auf Platz 4-10 mit Trafficverlust zur Inhaltsoptimierung. | Einsparung von 6 Stunden Arbeitszeit pro Woche; Steigerung der Ranking-Relevanz. |
| Echtzeit-Budget-Reallokation | Google Analytics, Google Ads, Meta Ads | Überwachung der CPA-Grenzwerte auf Kampagnenebene mit automatischem Pausieren bei Abweichungen. | Vermeidung von Fehlbudgetierungen; proaktive Kampagnenoptimierung im Minuten-Takt. |
| Conversational Product Discovery | Mixpanel, SQL-Datenbanken, Elasticsearch | MCP-gestützte Beantwortung komplexer Kundenfragen durch Echtzeit-Analysen von CRM-Daten. | Steigerung der Konversionsrate um das 4,4-fache gegenüber klassischer Suche. |
Ein besonders zukunftsträchtiger Ansatz ergibt sich aus der Übertragung von Karpathys autoresearch-Prinzip auf das digitale Marketing. In seinem ursprünglichen ML-Forschungsprojekt initiierte Karpathy ein System, das basierend auf drei Kerndateien:
- prepare.py für die Datenvorbereitung,
- train.py als Agenten-Spielwiese
- program.md als Instruktionsset autonom ein Sprachmodell optimierte.
Durch das Festlegen eines strikten Inferenz-Zeitbudgets von exakt 5 Minuten pro Durchlauf blieben alle Experimente direkt vergleichbar, wodurch das System über Nacht 126 Experimente durchführen und eine Effizienzsteigerung von 11 % aufzeigen konnte.
In datengetriebenen Marketing- und Tech-Teams wird dieses Prinzip zum Beispiel auf die Kampagnenoptimierung angewendet. Der Agent erhält ein festes Inferenz-Zeitbudget und die Erlaubnis, Gebote, Keyword-Listen und Anzeigenformate in einem geschützten Pre-Production-Werbekonto autonom zu variieren. Als Optimierungsmetrik dient hierbei die synthetisch berechnete Conversion-Wahrscheinlichkeit.
Über Nacht führt der Agent Hunderte simulierte Micro-Split-Tests durch, bewertet die Ergebnisse anhand mathematischer Grenzkostenkurven und verwirft ineffiziente Kampagnen-Layouts sofort. Die menschlichen Campaign Manager erhalten am nächsten Morgen ein optimiertes und validiertes Anzeigen-Setup, das die Leistung menschgemachter Entwürfe deutlich übertrifft, ohne dass manuelle Arbeitszeit für feingliedrige Einstellarbeiten aufgewendet werden muss.
Fazit und strategische Empfehlungen
Der Aufbau einer autonomen Karpathy-Agenten-Architektur markiert den Übergang von einer manuell gesteuerten zu einer software- und agenten-nativen Unternehmensstruktur.
Unternehmen, die sich frühzeitig auf diese Architektur ausrichten, sichern sich signifikante Effizienz- und Relevanzvorteile an den digitalen Schnittstellen der Zukunft. Für die Implementierungsempfehlen wir folgende strategische Schritte:
- Schaffung maschinenlesbarer Grundlagen: Bevor komplexe Agentensysteme integriert werden, müssen bestehende Web-Infrastrukturen durch die Implementierung von standardisierten Schemas, (Web-)MCP-Schnittstellen und dedizierten Wissensgraphen (ggf. mit einem Kontext- und semantischen Layer-System) für generative Synthese-Systeme verständlich aufbereitet werden.
- Etablierung strikter Sicherheitsarchitekturen: Der Einsatz vollautonomer Systeme erfordert die kompromisslose Definition von Rechtematrizen nach dem AGENTS.md-Standard. Kritische Systembereiche müssen durch hardwarenahe Sandboxes isoliert und an unumgängliche Freigabeprozesse durch menschliche Kontrollinstanzen gekoppelt werden.
- Inkrementelle Einführung fokussierter Spezialagenten: Statt monolithische Allzweck-KIs aufzubauen, ist die Etablierung modularer Agenten-Netzwerke mit klar abgegrenzten Aufgabenbereichen, individuellen Workspace-Dateien und vererbbaren Skill-Allowlists der technisch sicherere und wirtschaftlich effizientere Pfad.